模型评估之混淆矩阵 从矩阵到洞察,全面解读分类模型性能
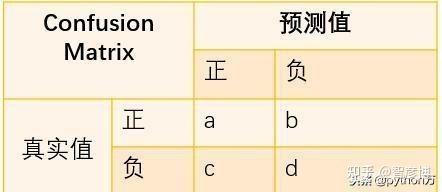
在机器学习领域,分类模型的评估至关重要。准确率虽然直观,但在类别不平衡的场景下容易产生误导。混淆矩阵(Confusion Matrix)作为一种基础而强大的评估工具,能够清晰展示模型在每个类别上的表现,是分类问题中不可或缺的分析手段。\n\n## 一、什么是混淆矩阵?\n\n混淆矩阵是一个 N×N 的表格(N 为类别数),用于分类模型的预测结果。以二分类为例,矩阵的每一行代表样本的真实类别,每一列代表模型的预测类别(或相反,取决于约定)。典型布局如下:\n\n| | 预测为正类 | 预测为负类 |\n|----------------|------------|------------|\n| 真实正类 | TP | FN |\n| 真实负类 | FP | TN |\n\n其中:\n- TP(True Positive):正类被正确预测为正类\n- TN(True Negative):负类被正确预测为负类\n- FP(False Positive):负类被错误预测为正类(误报)\n- FN(False Negative):正类被错误预测为负类(漏报)\n\n对于多分类问题,混淆矩阵扩展为K×K的表格,每个元素 (i, j) 表示真实类别为 i 但被预测为 j 的样本数量。\n\n## 二、从混淆矩阵导出的核心指标\n\n混淆矩阵本身是一个计数矩阵,但通过它可以计算出多种评估指标,全面刻画模型性能。\n\n### 1. 准确率(Accuracy)\n准确率 = (TP + TN) / (TP + TN + FP + FN)。\n
适用场景:类别分布均衡时。
局限:在类别不平衡时,高准确率可能意味着模型只是预测了多数类。\n\n### 2. 精确率(Precision)\n精确率 = TP / (TP + FP)。
表示预测为正的样本中,实际为正的比例。
关注点:降低误报(FP)。适用于垃圾邮件识别、推荐系统等场景。\n\n### 3. 召回率(Recall / Sensitivity)\n召回率 = TP / (TP + FN)。
表示真实为正的样本中,被正确预测的比例。
关注点:降低漏报(FN)。适用于疾病诊断、欺诈检测等场景。\n\n### 4. F1分数(F1-Score)\nF1 = 2 × (Precision × Recall) / (Precision + Recall)。
精确率和召回率的调和平均,综合平衡两者。\n\n### 5. 特异度(Specificity)\n特异度 = TN / (TN + FP)。
表示真实为负的样本中,被正确预测的比例。\n\n### 6. 其他指标\n- 假正率(FPR):FP / (FP + TN) = 1 - 特异度\n- 假负率(FNR):FN / (FN + TP) = 1 - 召回率\n- 平衡准确率(Balanced Accuracy):(召回率 + 特异度) / 2\n- 马修斯相关系数(MCC):综合考虑TP, TN, FP, FN,取值范围[-1, 1],适合不平衡数据。\n\n## 三、混淆矩阵的可视化\n\n热力图是最常见的可视化方式,用颜色深浅表示数值大小,能直观看出模型在哪些类别上容易混淆。\n\n`python\nimport matplotlib.pyplot as plt\nimport seaborn as sns\nfrom sklearn.metrics import confusionmatrix\n\n# 假设 ytrue 为真实标签,ypred 为预测标签\ncm = confusionmatrix(ytrue, ypred)\nsns.heatmap(cm, annot=True, fmt='d', cmap='Blues')\nplt.xlabel('Predicted')\nplt.ylabel('Actual')\nplt.title('Confusion Matrix')\nplt.show()\n`\n\n通常还需对矩阵进行归一化(按行或按列),以消除类别样本量差异带来的影响。\n\n## 四、多分类下的混淆矩阵分析\n\n多分类问题中,混淆矩阵能揭示哪些类别容易被混淆。例如,在手写数字识别中,数字“3”可能常被误判为“8”。分析矩阵的非对角线元素有助于发现模型弱点:\n\n- 类别级指标:可计算每个类别的精确率、召回率、F1分数,宏平均(Macro-average)、微平均(Micro-average)和加权平均(Weighted-average)。\n - 宏平均:各类别指标算术平均,平等对待每个类别。\n - 微平均:全局计算TP, FP, FN,然后计算指标,受样本量大的类别主导。\n - 加权平均:按类别样本量加权平均。\n\n## 五、混淆矩阵的应用案例\n\n### 1. 医疗诊断\n在癌症筛查中,漏诊(FN)代价极高,因此需要高召回率。通过混淆矩阵调整分类阈值,减少FN,即使增加FP。\n\n### 2. 欺诈检测\n欺诈交易极少,属于极度不平衡数据。仅看准确率可能高达99.9%,但模型可能从未预测出欺诈。混淆矩阵中的TP和FN才能真正反映检测能力。\n\n### 3. 情感分析\n三分类(正面、负面、中性)中,混淆矩阵可帮助理解中性样本是否与实际带有情感倾向的样本混淆。\n\n## 六、混淆矩阵的局限与注意事项\n\n- 阈值依赖:对于概率输出模型,混淆矩阵依赖于分类阈值。默认0.5不一定最优,可通过ROC曲线或PR曲线选择阈值。\n- 类别顺序:二分类中“正类”的定义影响指标解读;多分类中类别的排列顺序影响可读性。\n- 不平衡数据:需结合其他指标(如MCC、Kappa系数、F1)综合判断。\n- Kappa系数:衡量分类一致性,排除随机一致性的影响。\n\n## 七、\n\n混淆矩阵是分类模型评估的基石,它像一面镜子,清晰地映射出模型在每个类别上的表现。从矩阵出发,我们可以计算出精确率、召回率、F1分数等一系列指标,并通过可视化深入理解模型的优势与不足。在实际应用中,应结合具体业务场景选择合适指标,并注意类别不平衡、阈值选择等问题,从而构建更可靠、更有价值的分类模型。
如若转载,请注明出处:http://www.emarketing-cn-mail.com/product/51.html
更新时间:2026-10-05 05:03:30